
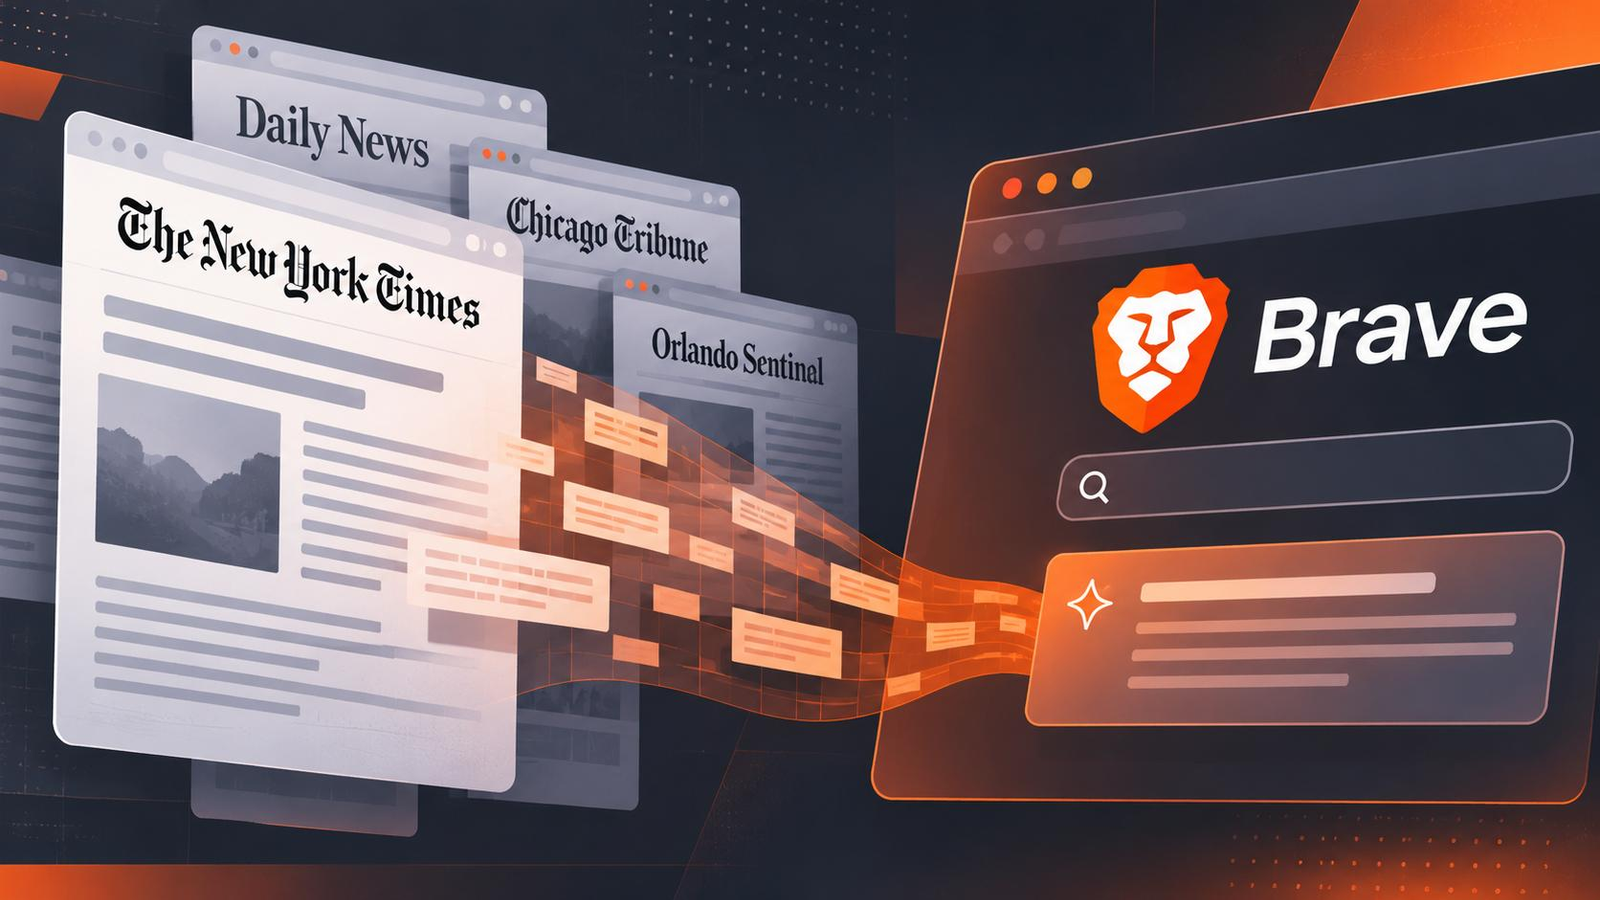
The New York Times y los editores de Daily News, Chicago Tribune y Orlando Sentinel presentaron dos demandas en Manhattan contra Brave Software.
The New York Times Company y los editores de Daily News, Chicago Tribune y Orlando Sentinel presentaron el 2 de noviembre de 2026 dos demandas en la corte federal del Distrito Sur de Nueva York contra Brave Software, la empresa detrás del navegador Brave y del motor de búsqueda Brave Search.
Las demandas acusan a Brave de copiar artículos periodísticos en un índice de más de 30.000 millones de páginas web y de distribuirlos a empresas de inteligencia artificial, además de permitir a los usuarios del navegador sortear los paywalls de los medios. El Times busca una orden judicial y una indemnización por daños, incluyendo las ganancias de Brave.
En la demanda del Times (caso 26-cv-9549), la empresa describe a Brave como “el proveedor, distribuidor y comercializador de contenido con derechos de autor robado”, y compara su funcionamiento con el de un ladrón que extrae contenido y un perista que lo vende a terceros.
La segunda demanda (caso 26-cv-9554), presentada por Daily News LP, Chicago Tribune Company LLC y Orlando Sentinel Communications Company LLC, replica los mismos argumentos. Ambas fueron firmadas por el abogado Steven Lieberman, del estudio Rothwell, Figg, Ernst & Manbeck, y ambas exigen juicio por jurado.
El mecanismo central del caso es el Brave Index, una colección de más de 30.000 millones de páginas web que alimenta Brave Search. Según las demandas, Brave nunca ha revelado el nombre del crawler que recolecta ese material, lo que impide a los editores bloquearlo selectivamente mediante archivos robots.txt.
Los publicadores argumentan que Brave “nunca pidió permiso para acceder a sus sitios web, mucho menos para copiar el material y proporcionarlo a usuarios o a otras empresas de IA”, y que tampoco los compensó por ese uso.
Venta a empresas de IA y feature “Ask Brave”
La demanda afirma que Brave monetiza su índice vendiendo acceso a “contenido en línea en tiempo real” a empresas de IA, que lo usan para entrenar modelos o para responder consultas de usuarios. Los clientes nombrados son Anthropic, Perplexity, Mistral, xAI y Cohere. Ninguna de estas empresas es demandada en los casos; se las menciona como compradores del índice.
Además de la venta a terceros, las demandas apuntan a “Ask Brave”, la función de respuestas con IA del navegador, que reproduce artículos de los medios. Brave también bloquea los anuncios de los editores y sustituye los propios, lo que según los demandantes les quita ingresos publicitarios.
Brave no respondió a las solicitudes de comentario de Reuters, TechCrunch ni The Verge. Anthropic, Mistral, xAI y Cohere tampoco comentaron. Perplexity respondió con una declaración despectiva: “The New York Times está pagando de más a sus abogados y de menos a sus periodistas.”
Tres tipos de infracción y DMCA
Las demandas incluyen cinco reclamos: infracción directa, contributiva y vicaria de derechos de autor, circunvención de medidas de protección tecnológica bajo la DMCA (Digital Millennium Copyright Act) y enriquecimiento injusto bajo la ley de Nueva York. El argumento de la DMCA es que Brave elude las barreras técnicas que los editores usan para restringir el acceso a sus artículos, incluyendo los paywalls.
El Times también busca que Brave cierre su “bloqueador de paywalls”, una función que permite a los usuarios leer artículos pagos sin suscripción. Según el Times, Brave promociona el acceso a “cientos de los principales editores” a través de esa función.
El Times ha demandado previamente a OpenAI y Perplexity por reclamos similares, lo que sitúa a Brave en una estrategia legal más amplia contra intermediarios de datos para IA. Brave es una empresa de 11 años, fundada en 2015, que ha recaudado aproximadamente 250 millones de dólares. El litigio puede ser existencialmente costoso para la compañía, dado su tamaño frente a los demandantes.
El punto técnico central es la falta de identificación del crawler. Los editores no pueden bloquearlo por nombre en sus archivos robots.txt, lo que les quita control sobre qué contenido se indexa.
Para editores latinoamericanos que publican en la web abierta, este caso plantea una pregunta directa: si un intermediario raspa contenido sin identificarse y lo vende a empresas de IA, ¿qué mecanismos tiene un medio para proteger su trabajo? La demanda del Times busca establecer que la indexación masiva sin consentimiento y su comercialización constituyen infracción de derechos de autor.
El debate sobre scraping y licencias
El caso se suma a una serie de litigios en Estados Unidos sobre el uso de contenido protegido para entrenar modelos de IA. La diferencia de esta demanda es que ataca a un intermediario de datos, no al modelo en sí.
Si los tribunales aceptan que la venta de un índice construido con scraping masivo es ilegal, el precedente afectaría a cualquier empresa que recopile y comercialice contenido de terceros para IA, incluyendo agregadores y motores de búsqueda que operan en la región.